
共享前缀:让多个判断复用同一段上下文
前置阅读:从 JevRequest 到 LLM 输入,先了解为什么一个请求会产生多个候选判断,以及这些分数如何组成最终答案。
本页的 LLM 指用于候选评分的大语言模型,例如 Qwen3。一次 LLM2Jev 请求可以对同一份材料提出多个问题。共享前缀缓存让这些判断复用 LLM 已经处理过的输入前缀,减少重复计算。对于长上下文、多候选的请求,即使没有任何历史请求命中缓存,也可以获得明显加速。
本页介绍本地 Python SGLangBackend 和 llm2jev-serve 的 /v1/systemone 接口。两者默认使用分阶段提交;TransformersBackend 尚未接入这套提交策略。
为什么同一份材料会被计算多次?
假设 state 是一段客户描述:“包裹晚到了两周,信用卡还被扣了两次。”questions 中包含 department(负责部门)和 severity(严重程度)两道题,每道题都有自己的 instructions 和 criteria。
| Jev 字段 | 在本例中的含义 | 候选输入之间的关系 |
|---|---|---|
state | 客户描述 | 同一请求的所有候选共用 |
questions.department.instructions | 哪个部门应该处理这个请求? | department 的候选共用 |
questions.severity.instructions | 这个问题有多严重? | severity 的候选共用 |
每道题的 criteria | 部门选项或严重程度等级的定义 | 每次判断取其中一个候选 |
LLM2Jev 会把 Choice 的每个 criteria 选项、Score 的每个 criteria 等级分别变成一个 yes/no 判断。每个输入包含 state、所属题的 instructions,以及当前候选的名称或等级和定义。输入的共享关系可以理解为:
state:客户描述
├── questions.department.instructions:负责部门?
│   ├── criteria["shipping"]:物流配送
│   ├── criteria["billing"]:扣款和账单
│   └── criteria["returns"]:退货和换货
└── questions.severity.instructions:严重程度?
    ├── criteria[0]:低
    ├── criteria[1]:中
    └── criteria[2]:高
因此,包含 state 的公共前缀可以跨题复用,包含某道题 instructions 的更长前缀可以在该题的候选之间复用。state 或 instructions 越长、criteria 候选越多,重复处理这部分输入的成本越高。
LLM 处理输入时会产生用于注意力计算的中间结果,通常称为 KV cache。后续输入如果具有完全相同的开头,就可以复用这部分结果,从不同的位置继续计算。共享依据是分词后的实际 token 前缀;意思相近或出现在不同位置的文字,不保证可以复用。上图是概念示意,用户无需手动标注共享边界。
分阶段提交如何帮助第一次请求?
仅仅开启缓存,不保证同时到达的候选能互相复用。在我们的测试中,一次提交所有候选时,同批候选开始计算时尚没有可用的公共缓存,仍重复处理了共享内容。
分阶段提交会先评分一个实际候选,让它建立公共前缀的缓存,再提交能够复用该缓存的其他候选。如果还有更深的分叉,就继续分轮处理;互不依赖的分支可以在同一轮提交。
下图展示同一个冷请求中的三轮提交。每行从左到右对应 state、所属题的 instructions 和一个 criteria 候选;department 指部门问题,severity 指严重程度问题。Choice 的 criteria.shipping 是 criteria["shipping"] 的简写,包含选项名称及定义。蓝色实线块(New computation)表示本轮需要计算的部分,绿色虚线块(Reuse cached KV)表示复用之前轮次已经建立的 KV;右侧展示每轮结束后的公共缓存。
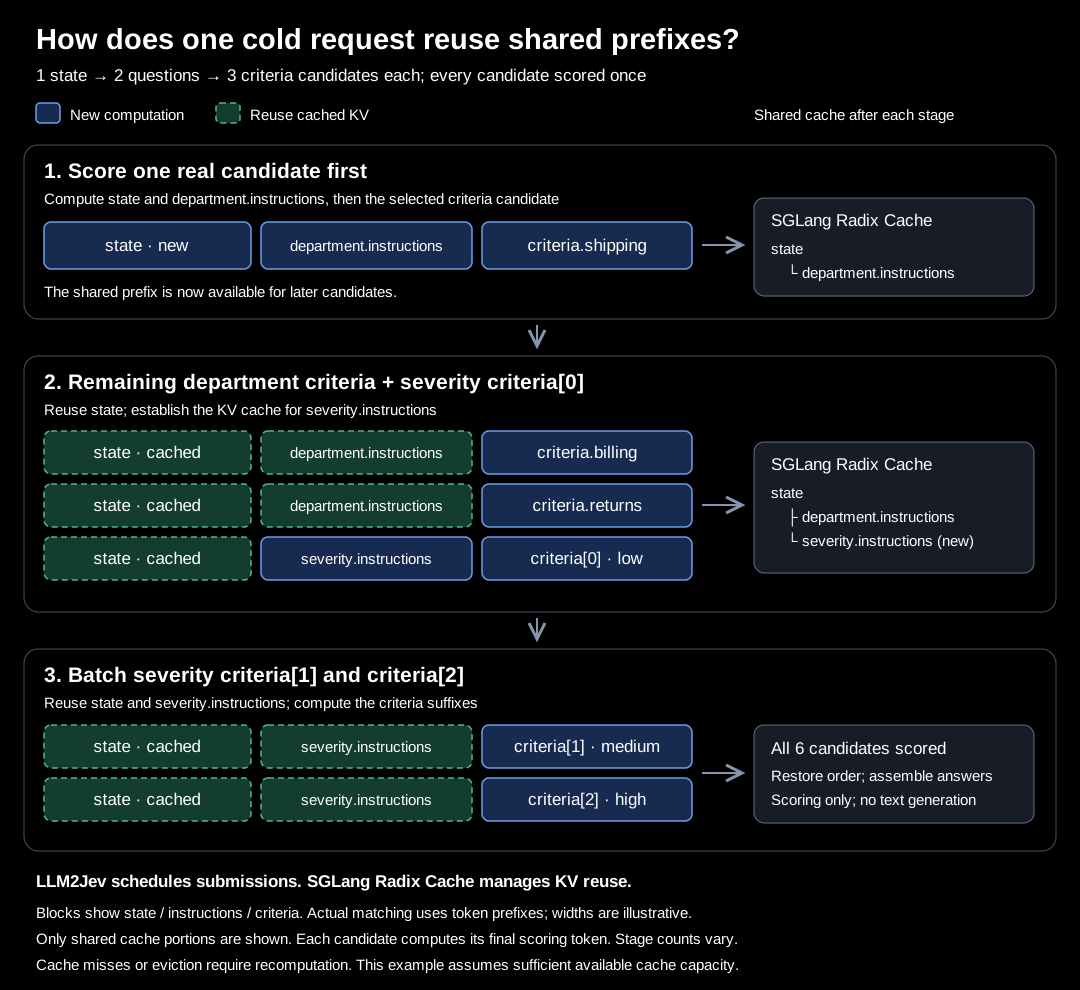
图中的提交顺序是:
- 先评分
department.criteria["shipping"],建立包含state和department.instructions的前缀缓存。 department的billing、returns候选复用上述前缀;同批提交的severity.criteria[0]复用state前缀,并建立包含severity.instructions的更长缓存。- 评分
severity.criteria[1]和severity.criteria[2],复用包含state和该题instructions的前缀。
每个候选只评分一次,没有额外的预热问题。完整输入及其含义保持不变,结果按原来的问题和候选顺序返回。实际分组由 token 前缀决定,不固定为三轮。
这里的冷请求指相关输入的 KV 缓存还不存在,但模型已经加载、计算内核已预热;热请求指相关前缀已在缓存中。分阶段可以在一个冷请求内部建立并复用缓存,不需要用户重复发送请求。它不加速模型加载或首次内核编译。
直接复用 SGLang 的 Radix Cache
这套方式使用 SGLang 已有的 Radix Cache 保存并复用公共前缀的 KV。Radix Cache 按 token 前缀组织缓存:后续候选到达时,引擎查找可以复用的前缀,从尚未计算的位置继续执行。SGLang 也负责底层 KV 内存管理和缓存驱逐。
LLM2Jev 负责的是提交顺序:根据完整输入的 token 前缀,先选真实候选建立缓存,再提交能够复用它的分支。state、instructions、criteria 用来解释这些输入的内容;缓存匹配实际发生在渲染、应用聊天模板和完整分词之后,不是按字段名称直接缓存。输入仍以完整 token 序列交给 SGLang,用户不需要拆分输入或手动传递 KV。每个候选的最后评分位置仍需要计算,以取得 yes/no 分数。
因此,两者配合才能获得图中的效果:Radix Cache 提供复用能力,分阶段提交让后续候选到达时已有可用缓存。仅将所有候选同时交给引擎,不保证冷批次内部的公共前缀只计算一次;缓存被驱逐时,也需要重新计算相应部分。
使用方法和模式选择见使用指南,实测数据和测试条件见性能测评。
输出和缓存需要注意什么?
两种方式都只处理输入并读取下一 token 的 yes/no 分数,不生成回答文本。返回的 Choice、Score、Noul 结构相同;usage.input_tokens 仍统计所有完整候选输入的逻辑 token 总数,usage.output_tokens 为 0。缓存命中减少实际计算量,不会降低这个逻辑 usage 数字。
BF16 下,提交顺序和 batch 形状变化可能造成概率差异;接近并列的候选可能改变最终选择。比较模式时,应查看归一化后的最终答案和 Score 连续值。两个候选都偏向 yes 不直接代表整题错误,仍以组装后的结果为准;共享前缀本身也不保证提高模型判断能力。
分阶段要求启用 SGLang 的 Radix Cache,与 Python 配置 engine_kwargs={"disable_radix_cache": True} 或服务启动参数 --disable-radix-cache 同时使用会报错。缓存的分配、复用和驱逐由 SGLang 管理:同一个引擎可能在多个请求间保留前缀,显存不足时也可能驱逐它们。复用命中不保证 GPU 显存占用同步下降,因为引擎可以预先分配 KV 池。
目前请对同一个 Python 后端实例串行调用;HTTP 服务的分阶段策略也尚未完成并发性能验证。